
O Amazon Polly é o serviço de Text-to-Speech (TTS) da AWS. Sua função é transformar textos em fala sintetizada, permitindo que sistemas produzam áudio automaticamente a partir de conteúdo textual.
Seu funcionamento básico pode ser resumido assim:
Texto -> Amazon Polly -> ÁudioUma aplicação pode enviar, por exemplo:
Olá! Seja bem-vindo à SatellaSoft.
O Amazon Polly sintetiza o conteúdo utilizando a voz e as configurações escolhidas e retorna o áudio correspondente.
Amazon Polly e Amazon Transcribe
Uma maneira simples de entender o Polly é compará-lo com o Amazon Transcribe.
| Serviço | Entrada | Saída |
|---|---|---|
| Amazon Transcribe | Áudio | Texto |
| Amazon Polly | Texto | Áudio |
Enquanto o Transcribe identifica o que foi falado em um áudio, o Polly realiza o caminho contrário: recebe um texto e produz uma voz.
Para que serve o Amazon Polly?
O serviço pode ser utilizado sempre que um sistema precisar apresentar informações através de voz.
Alguns exemplos são:
- Acessibilidade: leitura de páginas e conteúdos para usuários;
- Artigos em áudio: criação automática de versões narradas de publicações;
- E-learning: narração de materiais educacionais e treinamentos;
- Atendimento: mensagens utilizadas em URAs e sistemas telefônicos;
- Aplicativos: leitura de notificações e informações;
- IoT: dispositivos capazes de fornecer respostas através de voz;
- Games: geração de falas, diálogos e instruções;
- Conteúdo digital: criação de narrações a partir de textos.
Um portal de notícias, por exemplo, poderia utilizar o Polly para disponibilizar a opção “Ouvir este artigo”.
Como funciona o Amazon Polly?
A aplicação envia uma solicitação contendo o texto e as configurações desejadas.
Entre essas configurações podemos informar:
- Texto;
- Idioma;
- Voz;
- Engine;
- Formato do áudio;
- Tipo do texto.
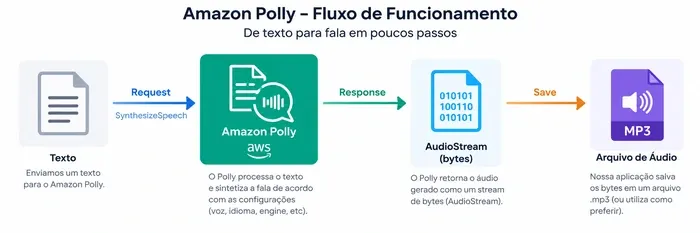
O fluxo é:
Texto ->
Request ->
Amazon Polly ->
Response ->
AudioStream (bytes)
O Polly não precisa criar um arquivo diretamente no computador ou servidor, você pode ter uma página com um cabeçalho que retorna o tipo mp3 com o conteúdo gerado a partir do AudioStream.
Formatos de áudio
Ao solicitar a síntese, também podemos definir o formato de saída.
Entre os formatos suportados pelo serviço estão opções como MP3, OGG Vorbis e PCM.
Portanto, o formato faz parte da configuração da síntese:
Texto ->
Amazon Polly ->
AudioStream ->
MP3 / OGG / PCM
É importante não confundir entrada e saída: não enviamos um MP3 para o Polly realizar Text-to-Speech.
A entrada principal é o texto. O áudio é o resultado.
O que é Neural TTS?
TTS significa Text-to-Speech.
O Amazon Polly disponibiliza diferentes mecanismos, ou engines, responsáveis pela geração das vozes.
Standard
Mecanismo tradicional de síntese de fala.
Neural
O Neural Text-to-Speech (NTTS) utiliza modelos neurais para produzir uma fala mais natural.
Long-form
Voltado à síntese de conteúdos extensos, como materiais educacionais e outros textos longos.
Generative
Utiliza tecnologia generativa para produzir uma fala mais natural e expressiva.
A disponibilidade de cada engine depende de fatores como voz, idioma e região.
Para um projeto utilizando Neural TTS, por exemplo, poderíamos ter:
Engine: neural
Language: pt-BR
Output: mp3
Escolhendo uma voz
O Polly possui um catálogo de vozes disponíveis para diferentes idiomas.
Ao solicitar uma síntese, podemos escolher qual delas será responsável pela leitura.
Conceitualmente:
Texto: "Bem-vindo à SatellaSoft"

Idioma: pt-BR
Voz: voz compatível
Engine: Neural
Formato: MP3
A AWS também disponibiliza a operação DescribeVoices, permitindo que um sistema consulte programaticamente quais vozes estão disponíveis.
Isso possibilita, por exemplo, construir uma aplicação na qual o próprio usuário escolha a voz utilizada para gerar o áudio.
O que é SSML?
Além de texto comum, o Amazon Polly suporta SSML (Speech Synthesis Markup Language).
SSML é uma linguagem de marcação padronizada pelo W3C para controlar aspectos da síntese de fala.
Sua estrutura lembra XML:
<speak>
    Olá!

    <break time="2s"/>

    Bem-vindo à SatellaSoft.
</speak>
Nesse exemplo, indica que deve existir uma pausa de dois segundos naquele ponto.
<break time="2s"/>Portanto, podemos pensar assim:
Texto -> O que falar
SSML  -> Como falar
O SSML não é uma tecnologia criada exclusivamente pela AWS. É um padrão utilizado para síntese de fala, embora cada plataforma possa implementar diferentes partes e extensões desse padrão.
Ao utilizar o Polly, é necessário verificar quais elementos SSML são suportados pelo serviço e pela engine escolhida.
Texto comum ou SSML?
Ao solicitar uma síntese, precisamos informar qual tipo de conteúdo estamos enviando.
Para texto normal:
TextType: textPara conteúdo com marcações SSML:
TextType: ssmlAssim, o Polly sabe se deve simplesmente sintetizar o conteúdo ou interpretar também as marcações existentes.
Como funciona a cobrança do Amazon Polly?
Um ponto importante é que o custo da síntese está relacionado principalmente à quantidade de caracteres processados, de acordo com a engine utilizada.
Durante nossa estimativa no AWS Pricing Calculator utilizamos o seguinte cenário:
100 solicitações por mês
×
1.000 caracteres por solicitação
=
100.000 caracteres por mês
Para Neural Text-to-Speech, o valor apresentado no Calculator para esse cenário foi:
100.000 caracteres
×
US$ 0,000016
=
US$ 1,60/mês
Ou seja, nesse exemplo teríamos aproximadamente US$ 1,60 por mês para a síntese de 100 mil caracteres.
Os valores devem sempre ser conferidos no momento da implementação, pois preços e disponibilidade podem variar.
O tamanho do MP3 interfere no preço?
Esse é um detalhe importante.
No cenário de Text-to-Speech que calculamos, a cobrança da síntese não é determinada pelo tamanho final do arquivo MP3.
O cálculo considera os caracteres sintetizados.
1.000 caracteres ->
Amazon Polly ->
Áudio
O tamanho em KB ou MB do arquivo resultante não é o parâmetro utilizado para calcular essa síntese.
Caso esse arquivo seja posteriormente armazenado em outro serviço, como o Amazon S3, passam a existir também os custos relacionados àquele serviço.
SSML é cobrado como texto?
As próprias marcações SSML utilizadas para controlar a síntese não são consideradas da mesma maneira que o conteúdo textual efetivamente sintetizado.
Por exemplo:
<speak>
    Olá!
    <break time="2s"/>
    Bem-vindo à SatellaSoft.
</speak>
Tags como <speak> e <break> são instruções para o mecanismo de síntese, e não palavras que serão pronunciadas.
O que acontece com o áudio gerado?
Depois de processar a solicitação, o Polly retorna um AudioStream.
Podemos representar o processo completo assim:
Texto ->
Amazon Polly ->
AudioStream (bytes) ->
Aplicação ->
Destino
A partir do AudioStream, quem está utilizando o Polly pode decidir o destino do conteúdo.
Por exemplo, ele pode ser reproduzido diretamente, transformado em um arquivo MP3, armazenado no Amazon S3 ou utilizado como entrada em outro processo.
Essa separação é importante: o trabalho do Polly é sintetizar a fala e entregar o áudio. O armazenamento e a distribuição desse conteúdo pertencem à arquitetura que utiliza o serviço.
Conclusão
O Amazon Polly é uma solução de Text-to-Speech da AWS para transformar conteúdo textual em fala sintetizada.
Seu funcionamento é relativamente simples:
Texto -> Polly -> AudioStreamApesar dessa simplicidade, o serviço oferece recursos importantes, como diferentes vozes, idiomas, engines de síntese e suporte a SSML para controlar características da fala.
Além disso, seu modelo de cobrança baseado na quantidade de caracteres processados permite estimar previamente o custo de diferentes volumes de utilização.
Com essas características, o Amazon Polly pode ser utilizado em acessibilidade, educação, atendimento, artigos narrados, aplicativos, IoT, games e diversas outras soluções que precisam transformar informações textuais em voz.
Deixe um comentário