

Áudio está presente em diferentes tipos de aplicações. Uma reunião pode precisar ser documentada, uma palestra pode receber legendas e uma central de atendimento pode precisar transformar milhares de horas de conversas em informações que possam ser pesquisadas e analisadas.
O Amazon Transcribe é o serviço de reconhecimento de fala da AWS para esses cenários. Ele transforma áudio em texto utilizando reconhecimento automático de fala e pode trabalhar tanto com arquivos previamente gravados quanto com áudio transmitido em tempo real.
Além da transcrição, o serviço fornece informações sobre o processamento, como o momento em que cada palavra foi pronunciada e o nível de confiança do reconhecimento.
Onde utilizar o Amazon Transcribe
Um dos cenários mais comuns é a geração de legendas para vídeos, aulas e outros conteúdos multimídia. Como as palavras podem ser associadas aos seus respectivos momentos no áudio, o resultado também pode ser utilizado para sincronização e navegação pelo conteúdo.
Reuniões, entrevistas e palestras são outros bons exemplos. Depois de transformar a fala em texto, podemos armazenar o conteúdo, disponibilizar mecanismos de busca ou encaminhar a transcrição para outras etapas de processamento.
O mesmo conceito pode ser aplicado a chamadas de atendimento. Uma conversa transcrita deixa de ser apenas um arquivo de áudio e passa a ser uma informação que outros sistemas conseguem consultar e analisar.
Batch e o processamento assíncrono
Quando o áudio já foi gravado, podemos utilizar o processamento Batch do Amazon Transcribe. Nesse modelo, disponibilizamos o arquivo para o serviço e criamos um Transcription Job responsável pelo processamento.
Em nosso teste, utilizamos aproximadamente dez segundos de uma palestra em inglês. O áudio havia sido capturado por um celular durante um evento, a certa distância do palestrante e sem equipamentos profissionais de gravação.
O arquivo foi armazenado no Amazon S3 e, a partir da aplicação, iniciamos o job de transcrição.
transcription-c5f722db-1f77-46f8-be2d-068ff1a530cbA criação do job não significa que a transcrição estará disponível imediatamente. O Amazon Transcribe trabalha de maneira assíncrona: nossa aplicação solicita o processamento e pode continuar executando outras tarefas enquanto o serviço trabalha no arquivo.
Arquitetura da nossa transcrição
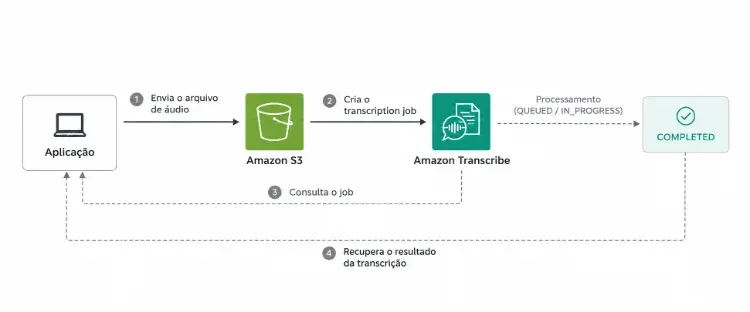
O fluxo começa com o arquivo armazenado no Amazon S3. A aplicação solicita ao Amazon Transcribe a criação de um novo job e recebe o identificador dessa execução.
Depois disso, podemos consultar o job utilizando esse identificador. Enquanto o arquivo está sendo processado, encontramos estados como QUEUED ou IN_PROGRESS. Quando o estado passa para COMPLETED, a transcrição está disponível.
Esse comportamento é importante para a arquitetura da aplicação. Em vez de manter uma requisição aberta esperando o processamento terminar, iniciamos uma tarefa e voltamos posteriormente para verificar seu resultado.
O que recebemos do Amazon Transcribe
Depois que nosso teste foi concluído, recebemos uma estrutura semelhante a esta:
{
  "jobName": "transcription-c5f722db-1f77-46f8-be2d-068ff1a530cb",
  "accountId": "398036158808",
  "status": "COMPLETED",
  "results": {
    "transcripts": [
      {
        "transcript": "So the final chapter is about shifting Lyft and delivering software safely. How many developers do we have in the room here? If you can raise your hands, please."
      }
    ],
    "items": [
      {
        "id": 0,
        "type": "pronunciation",
        "alternatives": [
          {
            "confidence": "1.0",
            "content": "So"
          }
        ],
        "start_time": "0.04",
        "end_time": "0.15"
      },
      {
        "id": 1,
        "type": "pronunciation",
        "alternatives": [
          {
            "confidence": "0.98",
            "content": "the"
          }
        ],
        "start_time": "0.15",
        "end_time": "0.43"
      },
      {
        "id": 2,
        "type": "pronunciation",
        "alternatives": [
          {
            "confidence": "0.989",
            "content": "final"
          }
        ],
        "start_time": "0.43",
        "end_time": "0.71"
      },
      {
        "id": 3,
        "type": "pronunciation",
        "alternatives": [
          {
            "confidence": "0.998",
            "content": "chapter"
          }
        ],
        "start_time": "0.71",
        "end_time": "1.15"
      },
      {
        "id": 4,
        "type": "pronunciation",
        "alternatives": [
          {
            "confidence": "0.998",
            "content": "is"
          }
        ],
        "start_time": "1.15",
        "end_time": "1.43"
      },
      {
        "id": 5,
        "type": "pronunciation",
        "alternatives": [
          {
            "confidence": "0.998",
            "content": "about"
          }
        ],
        "start_time": "1.43",
        "end_time": "1.66"
      },
      {
        "id": 6,
        "type": "pronunciation",
        "alternatives": [
          {
            "confidence": "0.998",
            "content": "shifting"
          }
        ],
        "start_time": "1.66",
        "end_time": "2.26"
      },
      {
        "id": 7,
        "type": "pronunciation",
        "alternatives": [
          {
            "confidence": "0.947",
            "content": "Lyft"
          }
        ],
        "start_time": "2.26",
        "end_time": "2.85"
      },
      {
        "id": 8,
        "type": "pronunciation",
        "alternatives": [
          {
            "confidence": "0.998",
            "content": "and"
          }
        ],
        "start_time": "3.08",
        "end_time": "3.47"
      },
      {
        "id": 9,
        "type": "pronunciation",
        "alternatives": [
          {
            "confidence": "0.988",
            "content": "delivering"
          }
        ],
        "start_time": "3.47",
        "end_time": "4.11"
      },
      {
        "id": 10,
        "type": "pronunciation",
        "alternatives": [
          {
            "confidence": "0.997",
            "content": "software"
          }
        ],
        "start_time": "4.11",
        "end_time": "5.07"
      },
      {
        "id": 11,
        "type": "pronunciation",
        "alternatives": [
          {
            "confidence": "0.984",
            "content": "safely"
          }
        ],
        "start_time": "5.07",
        "end_time": "5.74"
      },
      {
        "id": 12,
        "type": "punctuation",
        "alternatives": [
          {
            "confidence": "0.0",
            "content": "."
          }
        ]
      },
      {
        "id": 13,
        "type": "pronunciation",
        "alternatives": [
          {
            "confidence": "1.0",
            "content": "How"
          }
        ],
        "start_time": "6.05",
        "end_time": "6.19"
      },
      {
        "id": 14,
        "type": "pronunciation",
        "alternatives": [
          {
            "confidence": "0.981",
            "content": "many"
          }
        ],
        "start_time": "6.19",
        "end_time": "6.56"
      },
      {
        "id": 15,
        "type": "pronunciation",
        "alternatives": [
          {
            "confidence": "0.973",
            "content": "developers"
          }
        ],
        "start_time": "6.56",
        "end_time": "7.07"
      },
      {
        "id": 16,
        "type": "pronunciation",
        "alternatives": [
          {
            "confidence": "0.999",
            "content": "do"
          }
        ],
        "start_time": "7.07",
        "end_time": "7.17"
      },
      {
        "id": 17,
        "type": "pronunciation",
        "alternatives": [
          {
            "confidence": "0.991",
            "content": "we"
          }
        ],
        "start_time": "7.17",
        "end_time": "7.35"
      },
      {
        "id": 18,
        "type": "pronunciation",
        "alternatives": [
          {
            "confidence": "0.998",
            "content": "have"
          }
        ],
        "start_time": "7.35",
        "end_time": "7.47"
      },
      {
        "id": 19,
        "type": "pronunciation",
        "alternatives": [
          {
            "confidence": "0.989",
            "content": "in"
          }
        ],
        "start_time": "7.47",
        "end_time": "7.59"
      },
      {
        "id": 20,
        "type": "pronunciation",
        "alternatives": [
          {
            "confidence": "0.986",
            "content": "the"
          }
        ],
        "start_time": "7.59",
        "end_time": "7.75"
      },
      {
        "id": 21,
        "type": "pronunciation",
        "alternatives": [
          {
            "confidence": "0.985",
            "content": "room"
          }
        ],
        "start_time": "7.75",
        "end_time": "7.95"
      },
      {
        "id": 22,
        "type": "pronunciation",
        "alternatives": [
          {
            "confidence": "0.992",
            "content": "here"
          }
        ],
        "start_time": "7.95",
        "end_time": "8.15"
      },
      {
        "id": 23,
        "type": "punctuation",
        "alternatives": [
          {
            "confidence": "0.0",
            "content": "?"
          }
        ]
      },
      {
        "id": 24,
        "type": "pronunciation",
        "alternatives": [
          {
            "confidence": "0.998",
            "content": "If"
          }
        ],
        "start_time": "8.2",
        "end_time": "8.3"
      },
      {
        "id": 25,
        "type": "pronunciation",
        "alternatives": [
          {
            "confidence": "0.976",
            "content": "you"
          }
        ],
        "start_time": "8.3",
        "end_time": "8.43"
      },
      {
        "id": 26,
        "type": "pronunciation",
        "alternatives": [
          {
            "confidence": "0.914",
            "content": "can"
          }
        ],
        "start_time": "8.43",
        "end_time": "8.63"
      },
      {
        "id": 27,
        "type": "pronunciation",
        "alternatives": [
          {
            "confidence": "0.948",
            "content": "raise"
          }
        ],
        "start_time": "8.63",
        "end_time": "8.79"
      },
      {
        "id": 28,
        "type": "pronunciation",
        "alternatives": [
          {
            "confidence": "0.998",
            "content": "your"
          }
        ],
        "start_time": "8.79",
        "end_time": "8.98"
      },
      {
        "id": 29,
        "type": "pronunciation",
        "alternatives": [
          {
            "confidence": "0.565",
            "content": "hands"
          }
        ],
        "start_time": "9.0",
        "end_time": "9.26"
      },
      {
        "id": 30,
        "type": "punctuation",
        "alternatives": [
          {
            "confidence": "0.0",
            "content": ","
          }
        ]
      },
      {
        "id": 31,
        "type": "pronunciation",
        "alternatives": [
          {
            "confidence": "0.998",
            "content": "please"
          }
        ],
        "start_time": "9.28",
        "end_time": "9.67"
      },
      {
        "id": 32,
        "type": "punctuation",
        "alternatives": [
          {
            "confidence": "0.0",
            "content": "."
          }
        ]
      }
    ],
    "audio_segments": [
      {
        "id": 0,
        "transcript": "So the final chapter is about shifting Lyft and delivering software safely. How many developers do we have in the room here? If you can raise your hands, please.",
        "start_time": "0.0",
        "end_time": "9.79",
        "items": [
          0,
          1,
          2,
          3,
          4,
          5,
          6,
          7,
          8,
          9,
          10,
          11,
          12,
          13,
          14,
          15,
          16,
          17,
          18,
          19,
          20,
          21,
          22,
          23,
          24,
          25,
          26,
          27,
          28,
          29,
          30,
          31,
          32
        ]
      }
    ]
  }
}
O texto completo aparece em transcripts, mas o resultado não termina ali. Em items, encontramos cada palavra reconhecida acompanhada do seu start_time, end_time e confidence.
O campo confidence indica quanto o serviço confia naquele reconhecimento. Isso é particularmente interessante em gravações como a utilizada em nosso teste, nas quais distância, ruídos e qualidade do microfone podem dificultar a identificação de algumas palavras.
Os timestamps também permitem construir recursos como legendas sincronizadas ou interfaces nas quais o usuário seleciona uma parte da transcrição e acessa exatamente aquele momento do áudio.
Proteção de dados com PII
Uma transcrição também pode revelar informações que não deveriam ser disponibilizadas livremente. Isso se torna especialmente importante em chamadas de atendimento, entrevistas e outras gravações que podem conter dados pessoais.
O Amazon Transcribe possui recursos para identificação e redação de PII (Personally Identifiable Information). Com essa funcionalidade habilitada, o serviço pode identificar determinadas categorias de informações pessoais durante o processamento e produzir uma transcrição com esses dados ocultados.
Isso permite incorporar uma camada adicional de proteção ao fluxo de transcrição. Ainda assim, o recurso deve trabalhar em conjunto com controles de acesso, políticas de armazenamento e outras práticas de segurança adotadas pela aplicação.
Permissões IAM
Para executar nossa POC, a aplicação precisa ter acesso ao Amazon Transcribe e ao bucket S3 utilizado para armazenar os arquivos de áudio.
transcribe:StartTranscriptionJob— inicia a transcrição.transcribe:GetTranscriptionJob— consulta o status e o resultado.s3:GetObject— permite acessar o áudio.s3:PutObject— permite gravar arquivos no bucket.s3:ListBucket— permite listar os objetos.
{
    "Effect": "Allow",
    "Action": [
        "transcribe:StartTranscriptionJob",
        "transcribe:GetTranscriptionJob",
        "s3:GetObject",
        "s3:PutObject",
        "s3:ListBucket"
    ],
    "Resource": [
        "*",
        "arn:aws:s3:::satellasoft-aws-transcribe-lab",
        "arn:aws:s3:::satellasoft-aws-transcribe-lab/*"
    ]
}
Conclusão
O Amazon Transcribe vai além de simplesmente transformar áudio em texto. O resultado estruturado, os níveis de confiança e os timestamps permitem utilizar uma gravação como fonte de informação para diferentes funcionalidades e outros serviços.
Nosso teste também mostrou um cenário interessante: mesmo utilizando um pequeno trecho gravado por celular durante um evento, conseguimos obter uma transcrição estruturada e com informações suficientes para que a aplicação saiba inclusive onde o serviço teve maior ou menor confiança.
Deixe um comentário